#1.SQL的分类
--
-- DDL:数据定义语言。CREATE\ ALTER\ DROP	\RENAME	\TRUNCATE
-- DML:数据操作语言。INSERT	\DELETE	\UPDATE	\SELECT
-- DCL:数据控制语言	ROLHBACK\ SAVEPOINT	\GRANT	\REVOKE	\COMMIT

-- MySQL在Windows 环境下是大小写不敏感的
-- MySQL在Linux环境下是大小写敏感的
-- 数据库名、表名、表的别名、变量名是严格区分大小写的。
-- 关键字、函数名、列名(或字段名)、列的别名(字段的别名)是忽略大小写的。

-- 推荐采用统一的书写规范:
-- 数据库名、表名、表别名、字段名、字段别名等都小写。SQL关键字、函数名、绑定变量等都大写

-- use testdb;
-- source E:/F/testdb.sql;		#不要带中文路径 source命令行导入

-- select 1+1,2+2 from DUAL;   #DUAL 伪表

-- select * from employees;   #* 表中所有列

-- insert into test VALUES(1,'tom')	#插入语句要用 '' 单引号

-- select employee_id,last_name from employees;

#列的别名  空格、as(alias别名)、"" 双引号
-- select employee_id emp_id,last_name l_name from employees;
-- select employee_id as emp_id,last_name as l_name from employees;
-- select employee_id "部门id",last_name as "名字",salary * 12 "annual sal" from employees;

#去重
-- SELECT distinct department_id from employees;
#	salary在前会报错,在后不会报错,两列为整体看是否重复,实际查询无意义;
-- SELECT distinct department_id,salary from employees;

#空值参与运算  空值: null  ,null不等同于0,'','null'
-- SELECT * from employees;
#空值参与运算,结果一定为空
-- SELECT employee_id,salary,salary*(1+commission_pct)*12 "年薪",commission_pct "奖金" from employees;
#实际避免空值问题  引入IFNULL
-- SELECT employee_id,salary,salary*(1+IFNULL(commission_pct,0))*12 "年薪",commission_pct "奖金" from employees;

#着重号  ``;   存在与关键字冲突 用 ``着重号引着
-- select * from `order`;

#查询常数
-- select "学习" as "复习",employee_id emp_id,last_name l_name from employees;

# DESCRIBE  显示表结构 字段详细信息
-- DESCRIBE employees;
-- DESC employees;
-- +----------------+-------------+------+-----+---------+-------+
-- | Field | Type | Null | Key | Default | Extra |
-- +----------------+-------------+------+-----+---------+-------+
-- | employee_id | int(6) | NO | PRI | 0 | |
-- | first_name | varchar(20) | YES | | NULL | |
-- | last_name | varchar(25) | NO | | NULL | |
-- | email | varchar(25) | NO | UNI | NULL | |
-- | phone_number | varchar(20) | YES | | NULL | |
-- | hire_date | date | NO | | NULL | |
-- | job_id | varchar(10) | NO | MUL | NULL | |
-- | salary | double(8,2) | YES | | NULL | |
-- | commission_pct | double(2,2) | YES | | NULL | |
-- | manager_id | int(6) | YES | MUL | NULL | |
-- | department_id | int(4) | YES | MUL | NULL | |
-- +----------------+-------------+------+-----+---------+-------+
-- 其中,各个字段的含义分别解释如下:
-- Field:表示字段名称。
-- Type:表示字段类型,这里 barcode、goodsname 是文本型的,price 是整数类型的。
-- Null:表示该列是否可以存储NULL值。
-- Key:表示该列是否已编制索引。PRI表示该列是表主键的一部分;UNI表示该列是UNIQUE索引
-- 的一部分;MUL表示在列中某个给定值允许出现多次。

-- Default:表示该列是否有默认值,如果有,那么值是多少。
-- Extra:表示可以获取的与给定列有关的附加信息,例如AUTO_INCREMENT等。

#过滤数据   涉及到字符串的字段 用单引号 '';
-- select * from employees WHERE department_id = 90 and last_name = 'king' ;


-- 运算符
-- 运算符

-- 算术运算符主要用于数学运算,其可以连接运算符前后的两个数值或表达式,对数值或表达式进行加
-- (+)、减(-)、乘(*)、除(/)和取模(%或者mod 取余数)运算。

-- SELECT 100, 100 + 0, 100 - 0, 100 + 50, 100 + 50 -30, 100 + 35.5, 100 - 35.5 FROM dual;
-- SELECT 100 + '1' from DUAL;   #101  隐式转换
-- SELECT 100 + 'a' from DUAL;    #此时将a看作0来处理
-- SELECT 100 + null from DUAL;  		#  null
 /*
一个整数类型的值对整数进行加法和减法操作,结果还是一个整数;
一个整数类型的值对浮点数进行加法和减法操作,结果是一个浮点数;
加法和减法的优先级相同,进行先加后减操作与进行先减后加操作的结果是一样的;
在编程语言中,+的左右两边如果有字符串,那么表示字符串的拼接。但是在MySQL中+只表示数
值相加。如果遇到非数值类型,先尝试转成数值,如果转失败,就按0计算。(补充:MySQL
中字符串拼接要使用字符串函数CONCAT()实现)
*/

--  SELECT 100, 100 * 1, 100 * 1.0, 100 / 1.0, 100 / 2,100 % 3,100 mod 3,
-- 100 + 2 * 5 / 2,100 /3, 100 DIV 0 FROM dual;
 #100 DIV 0    :null
/*
一个数乘以整数1和除以整数1后仍得原数;
一个数乘以浮点数1和除以浮点数1后变成浮点数,数值与原数相等;
一个数除以整数后,不管是否能除尽,结果都为一个浮点数;
一个数除以另一个数,除不尽时,结果为一个浮点数,并保留到小数点后4位;
乘法和除法的优先级相同,进行先乘后除操作与先除后乘操作,得出的结果相同。
在数学运算中,0不能用作除数,在MySQL中,一个数除以0为NULL。
*/

/*
比较运算符用来对表达式左边的操作数和右边的操作数进行比较,比较的结果为真则返回1,比较的结果
为假则返回0,其他情况则返回NULL。
比较运算符经常被用来作为SELECT查询语句的条件来使用,返回符合条件的结果记录
=   <=>  <>   !=    <    <=    >     >=

*/

/*
等号运算符(=)判断等号两边的值、字符串或表达式是否相等,如果相等则返回1,不相等则返回
0。
在使用等号运算符时,遵循如下规则:
如果等号两边的值、字符串或表达式都为字符串,则MySQL会按照字符串ascll值进行比较,其比较的
是每个字符串中字符的ANSI编码是否相等。
如果等号两边的值都是整数,则MySQL会按照整数来比较两个值的大小。
如果等号两边的值一个是整数,另一个是字符串,则MySQL会将字符串转化为数字进行比较。
如果等号两边的值、字符串或表达式中有一个为NULL,则比较结果为NULL。
对比:SQL中赋值符号使用 :=
*/
#两边都是字符串的话,则按照ANsI的比较规则进行比较。
#字符串存在隐式转换。如果转换数值不成功,则看做0
#只要有nul1参与判断,结果就为nul1
-- SELECT 1 = 1, 1 = '1', 1 = 0, 'a' = 'a', (5 + 3) = (2 + 6), '' = NULL , NULL = NULL;
-- SELECT 1 = 2, 0 = 'abc', 1 = 'abc' ,'a' = 'a','a'='b','a'=0 FROM dual;
-- select last_name,salary from employees WHERE commission_pct = NULL;  #   不会有结果


/*
安全等于运算符 安全等于运算符(<=>)与等于运算符(=)的作用是相似的, 唯一的区别 是‘<=>’可
以用来对NULL进行判断。在两个操作数均为NULL时,其返回值为1,而不为NULL;当一个操作数为NULL
时,其返回值为0,而不为NULL。
空运算符 空运算符(IS NULL或者ISNULL)判断一个值是否为NULL,如果为NULL则返回1,否则返回0。
*/
-- SELECT 1 <=> '1', 1 <=> 0, 'a' <=> 'a', (5 + 3) <=> (2 + 6), '' <=> NULL,NULL<=> NULL FROM dual;
-- select last_name,salary,commission_pct from employees WHERE commission_pct IS NULL;  #用法一
-- select last_name,salary,commission_pct from employees WHERE ISNULL(commission_pct);  #用法二 函数用法
-- select last_name,salary,commission_pct from employees WHERE commission_pct <=> NULL;  #用法三

/*
不等于运算符 (<>和!=)用于判断两边的数字、字符串或者表达式的值是否不相等,
如果不相等则返回1,相等则返回0。不等于运算符不能判断NULL值。如果两边的值有任意一个为NULL,
或两边都为NULL,则结果为NULL。
非空运算符 非空运算符(IS NOT NULL)判断一个值是否不为NULL,如果不为NULL则返回1,否则返
回0。
*/
-- SELECT 1 <> 1, 1 != 2, 'a' != 'b', (3+4) <> (2+6), 'a' != NULL, NULL <> NULL;
-- select last_name,salary,commission_pct from employees WHERE commission_pct IS NOT NULL;  #用法


/*
最小值运算符 语法格式为:LEAST(值1,值2,...,值n)。其中,“值n”表示参数列表中有n个值。在有
两个或多个参数的情况下,返回最小值。
当参数是整数或者浮点数时,LEAST将返回其中最小的值;当参数为字符串时,返回字
母表中顺序最靠前的字符;当比较值列表中有NULL时,不能判断大小,返回值为NULL
*/
-- SELECT LEAST (1,0,2), LEAST('b','a','c'), LEAST(1,NULL,2) from DUAL;

/*
最大值运算符 语法格式为:GREATEST(值1,值2,...,值n)。其中,n表示参数列表中有n个值。当有
两个或多个参数时,返回值为最大值。假如任意一个自变量为NULL,则GREATEST()的返回值为NULL
当参数中是整数或者浮点数时,GREATEST将返回其中最大的值;当参数为字符串时,
返回字母表中顺序最靠后的字符;当比较值列表中有NULL时,不能判断大小,返回值为NULL。
*/
-- SELECT GREATEST(1,0,2), GREATEST('b','a','c'), GREATEST(1,NULL,2);

/*
BETWEEN AND运算符 BETWEEN运算符使用的格式通常为SELECT D FROM TABLE WHERE C BETWEEN A
AND B,此时,当C大于或等于A,并且C小于或等于B时,结果为1,否则结果为0。  (判断包含边界)
*/
-- SELECT 1 BETWEEN 0 AND 1, 10 BETWEEN 11 AND 12, 'b' BETWEEN 'a' AND 'c';
-- select last_name,salary from employees WHERE salary BETWEEN 8000 AND 12000;
-- select last_name,salary from employees WHERE salary NOT BETWEEN 8000 AND 12000;
-- select last_name,salary from employees WHERE salary BETWEEN 12000 AND 8000;   #查不到  顺序错了


/*
IN运算符 IN运算符用于判断给定的值是否是IN列表中的一个值,如果是则返回1,否则返回0。如果给
定的值为NULL,或者IN列表中存在NULL,则结果为NULL
NOT IN运算符 NOT IN运算符用于判断给定的值是否不是IN列表中的一个值,如果不是IN列表中的一
个值,则返回1,否则返回0
*/
-- SELECT 'a' IN ('a','b','c'), 1 IN (2,3), NULL IN ('a','b'), 'a' IN ('a', NULL);
-- SELECT 'a' NOT IN ('a','b','c'), 1 NOT IN (2,3);

/*
. LIKE运算符 LIKE运算符主要用来匹配字符串,通常用于模糊匹配,如果满足条件则返回1,否则返回
0。如果给定的值或者匹配条件为NULL,则返回结果为NULL
LIKE运算符通常使用如下通配符
“%”:匹配0个或多个字符。
“_”:一个_代表一个不确定的字符 占位符。
"\" :转义字符
ESCAPE  :回避特殊符号的:使用转义符。例如:将[%]转为[$%]、[]转为[$],然后再加上[ESCAPE‘$’]即可
REGEXP  (正则表达式)运算符用来匹配字符串,语法格式为: expr REGEXP 匹配条件 。如果expr满足匹配条件,返回
1;如果不满足,则返回0。若expr或匹配条件任意一个为NULL,则结果为NULL
REGEXP运算符在进行匹配时,常用的有下面几种通配符:
(1)‘^’匹配以该字符后面的字符开头的字符串。
(2)‘$’匹配以该字符前面的字符结尾的字符串。
(3)‘.’匹配任何一个单字符。
(4)“[...]”匹配在方括号内的任何字符。例如,“[abc]”匹配“a”或“b”或“c”。为了命名字符的范围,使用一
个‘-’。“[a-z]”匹配任何字母,而“[0-9]”匹配任何数字。
(5)‘*’匹配零个或多个在它前面的字符。例如,“x*”匹配任何数量的‘x’字符,“[0-9]*”匹配任何数量的数字,
而“*”匹配任何数量的任何字符。

*/
-- SELECT NULL LIKE 'abc', 'abc' LIKE NULL;
-- SELECT first_name FROM employees WHERE first_name LIKE 'S%';
-- SELECT first_name FROM employees WHERE first_name LIKE '%a%';
-- SELECT first_name FROM employees WHERE first_name LIKE '%e%a%';
-- SELECT last_name FROM employees WHERE last_name LIKE '_o%';
-- SELECT last_name FROM employees WHERE last_name LIKE '__e%';
-- SELECT last_name FROM employees WHERE last_name LIKE '_\_e%';   # \  转义字符  把 _ 占位符 变成着呢的下划线_ ;
-- SELECT last_name FROM employees WHERE last_name LIKE '_$_e%' ESCAPE '$';   # ESCAPE 自定义转义符 ;
-- SELECT 'shkstart' REGEXP '^s', 'shkstart' REGEXP 't$', 'shkstart' REGEXP 'hk';
-- SELECT last_name FROM employees WHERE last_name REGEXP '^e.*t$';

/*
逻辑运算符主要用来判断表达式的真假,在MySQL中,逻辑运算符的返回结果为1、0或者NULL

逻辑非运算符 逻辑非(NOT或!)运算符表示当给定的值为0时返回1;当给定的值为非0值时返回0;
当给定的值为NULL时,返回NULL。

逻辑与运算符 逻辑与(AND或&&)运算符是当给定的所有值均为非0值,并且都不为NULL时,返回
1;当给定的一个值或者多个值为0时则返回0;否则返回NULL。

逻辑或运算符 逻辑或(OR或||)运算符是当给定的值都不为NULL,并且任何一个值为非0值时,则返
回1,否则返回0;当一个值为NULL,并且另一个值为非0值时,返回1,否则返回NULL;当两个值都为
NULL时,返回NULL。

OR可以和AND一起使用,但是在使用时要注意两者的优先级,由于AND的优先级高于OR,因此先
对AND两边的操作数进行操作,再与OR中的操作数结合

逻辑异或运算符 逻辑异或(XOR)运算符是当给定的值中任意一个值为NULL时,则返回NULL;如果
两个非NULL的值都是0或者都不等于0时,则返回0;如果一个值为0,另一个值不为0时,则返回1。满足一个且不满足另一个。
*/
-- SELECT NOT 1, NOT 0, NOT(1+1), NOT !1, NOT NULL;
-- SELECT 1 AND -1, 0 AND 1, 0 AND NULL, 1 AND NULL;
-- SELECT 1 OR -1, 1 OR 0, 1 OR NULL, 0 || NULL, NULL || NULL;
-- SELECT 1 XOR -1, 1 XOR 0, 0 XOR 0, 1 XOR NULL, 1 XOR 1 XOR 1, 0 XOR 0 XOR 0;

/*
位运算符
位运算符是在二进制数上进行计算的运算符。位运算符会先将操作数变成二进制数,然后进行位运算,
最后将计算结果从二进制变回十进制数。

按位与运算符 按位与(&)运算符将给定值对应的二进制数逐位进行逻辑与运算。当给定值对应的二
进制位的数值都为1时,则该位返回1,否则返回0。

按位或运算符 按位或(|)运算符将给定的值对应的二进制数逐位进行逻辑或运算。当给定值对应的
二进制位的数值有一个或两个为1时,则该位返回1,否则返回0。

按位异或运算符 按位异或(^)运算符将给定的值对应的二进制数逐位进行逻辑异或运算。当给定值
对应的二进制位的数值不同时,则该位返回1,否则返回0。

按位取反运算符 按位取反(~)运算符将给定的值的二进制数逐位进行取反操作,即将1变为0,将0变
为1。

按位右移运算符 按位右移(>>)运算符将给定的值的二进制数的所有位右移指定的位数。右移指定的
位数后,右边低位的数值被移出并丢弃,左边高位空出的位置用0补齐。

按位左移运算符 按位左移(<<)运算符将给定的值的二进制数的所有位左移指定的位数。左移指定的
位数后,左边高位的数值被移出并丢弃,右边低位空出的位置用0补齐。

*/
位运算

优先级

常用正则规则

#排序
#排序
#排序

-- 使用 ORDER BY 子句排序
-- ASC(ascend): 升序
-- DESC(descend):降序
-- select last_name,salary from employees ORDER BY salary;		# 默认升序
-- select last_name,salary from employees ORDER BY salary DESC;
-- select last_name,salary from employees ORDER BY salary ASC;
-- select last_name,salary from employees ORDER BY department_id; #
-- select last_name,salary as "sal" from employees ORDER BY sal;#使用别名 排序的别名不要加引号
-- #select last_name,salary as "sal" from employees
-- where sal > 9000 ORDER BY sal;#报错!!列的别名禁止用在where中
-- select last_name,department_id,salary from employees ORDER BY department_id DESC,salary asc; ##多级排序


#分页
#分页
#分页
-- MySQL中使用 LIMIT 实现分页 	LIMIT [位置偏移量,] 行数    LIMIT(PageNo - 1)*PageSize,PageSize;
-- select last_name,salary from employees LIMIT 20;   #从第1行开始查20行
-- select last_name,salary from employees LIMIT 0,20;   #从第1行开始查20行
-- select last_name,salary from employees LIMIT 20,2;   #从第19行开始查2行
-- select last_name,salary from employees LIMIT 2 OFFSET 20; ##从第19行开始查2行    #OFFSET 8.0新特性


#多表查询
#多表查询
#多表查询

#查询字段中有多个表都存在的字段,必须指明表。建议每个字段都指定表名
-- 如果给表起了别名,一旦在SELECT或WHERE中使用表名的话,则必须使用表的别名,而不能再使用表的原名。
-- select emp.employee_id,dep.department_name,emp.department_id from employees emp,departments dep
-- WHERE emp.department_id = dep.department_id;

-- SELECT e.employee_id,d.department_name,l.city FROM employees e,departments d,locations l
-- WHERE e.department_id = d.department_id AND d.location_id = l.location_id;

#等值连接
-- SELECT e.last_name, e.salary, j.grade_level
-- FROM employees e, job_grades j
-- WHERE e.salary BETWEEN j.lowest_sal AND j.highest_sal;
#非等值连接
-- SELECT e.last_name, e.salary, j.grade_level
-- FROM employees e, job_grades j
-- WHERE e.salary >= j.lowest_sal AND e.salary <= j.highest_sal;

-- 自连接   (自己连接自己)
-- SELECT CONCAT(worker.last_name ,' works for '
-- , manager.last_name)
-- FROM employees worker, employees manager
-- WHERE worker.manager_id = manager.employee_id ;

-- 非自连接
-- select emp.employee_id,dep.department_name,emp.department_id
-- from employees emp,departments dep WHERE emp.department_id = dep.department_id;


-- 内连接: (条件匹配下共同的)
-- 合并具有同一列的两个以上的表的行, 结果集中不包含一个表与另一个表不匹配的行。
-- select emp.employee_id,dep.department_name from employees emp,departments dep
-- WHERE emp.department_id = dep.department_id;  #!92语法

-- select employee_id,department_name from employees e
--JOIN departments d on e.department_id = d.department_id;  #!99语法inner忽略 默认内连接

-- select employee_id,department_name from employees e INNER JOIN departments d
--on e.department_id = d.department_id;  #!99语法

-- select employee_id,department_name,city from employees e INNER JOIN departments d
-- on e.department_id = d.department_id INNER JOIN locations l on d.location_id = l.location_id;

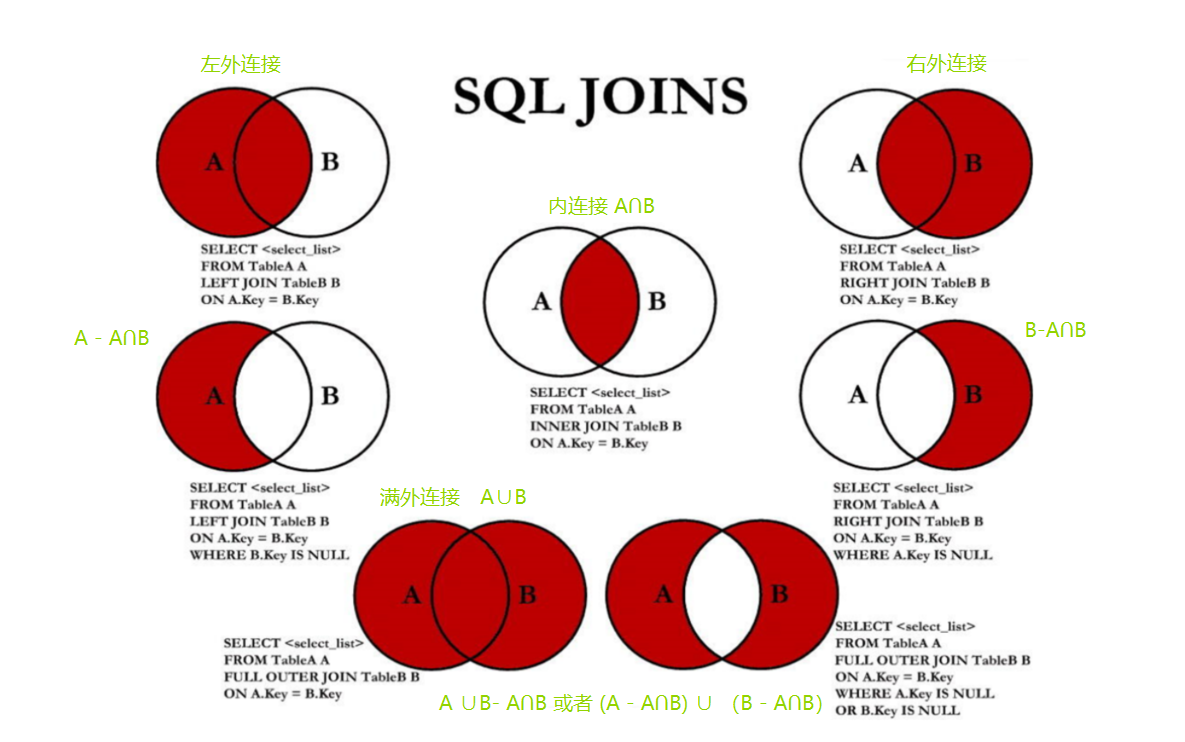
-- 外连接:    92语法不支持外连接;仅99语法
-- 两个表在连接过程中除了返回满足连接条件的行以外还返回左(或右)表中不满足条件的
-- 行 ,这种连接称为左(或右) 外连接。没有匹配的行时, 结果表中相应的列为空(NULL)。
-- 左外连接:两个表在连接过程中除了返回满足连接条件的行以外还返回左表中不满足条件的行,这种连接称为左外连接
-- 右外连接:两个表在连接过程中除了返回满足连接条件的行以外还返回石表中不满足条件的行,这种连接称为石外连接
-- select employee_id,department_name from employees e LEFT JOIN departments d
-- on e.department_id = d.department_id;
-- select employee_id,department_name from employees e LEFT OUTER JOIN departments d
-- on e.department_id = d.department_id;   #outer可省略

-- select employee_id,department_name from employees e RIGHT JOIN departments d
-- on e.department_id = d.department_id;

-- #mysql 不支持FULL OUTER JOIN
-- #select employee_id,department_name from employees e FULL JOIN departments d
-- on e.department_id = d.department_id;

-- select employee_id,department_name from employees e LEFT JOIN departments d
--on e.department_id = d.department_id UNION
-- select employee_id,department_name from employees e RIGHT JOIN departments d
-- on e.department_id = d.department_id;

-- select employee_id,department_name from employees e LEFT JOIN departments d
-- on e.department_id = d.department_id UNION ALL
-- select employee_id,department_name from employees e RIGHT JOIN departments d
-- on e.department_id = d.department_id WHERE e.department_id is NULL;

# UNION的用法说明
# UNION
# UNION

/*
UNION操作符返回两个查询的结果集的并集,去除重复记录。
*/
/*
UNION ALL操作符返回两个查询的结果集的并集。对于两个结果集的重复部分,不去重。
注意:执行UNION AL语句时所需要的资源比UNION语句少。如果明确知道合并数据后的结果数据不存在重复数据,
或者不需要去除重复的数据,则尽量使用UNION ALL语句,以提高数据查询的效率.
*/

/*
#内连接 A ∩ B
SELECT employee_id,last_name,department_name
FROM employees e JOIN departments d
ON e.`department_id` = d.`department_id`;

#左外连接
SELECT employee_id,last_name,department_name
FROM employees e LEFT JOIN departments d
ON e.`department_id` = d.`department_id`;

#右外连接
SELECT employee_id,last_name,department_name
FROM employees e RIGHT JOIN departments d
ON e.`department_id` = d.`department_id`;

#A - A∩B
SELECT employee_id,last_name,department_name
FROM employees e LEFT JOIN departments d
ON e.`department_id` = d.`department_id`
WHERE d.`department_id` IS NULL;

#B - A∩B
SELECT employee_id,last_name,department_name
FROM employees e RIGHT JOIN departments d
ON e.`department_id` = d.`department_id`
WHERE e.`department_id` IS NULL;


#满外连接 A∪B
SELECT employee_id,last_name,department_name
FROM employees e LEFT JOIN departments d
ON e.`department_id` = d.`department_id`
WHERE d.`department_id` IS NULL
UNION ALL #没有去重操作,效率高
SELECT employee_id,last_name,department_name
FROM employees e RIGHT JOIN departments d
ON e.`department_id` = d.`department_id`;

# A∪B-A∩B 或者 (A-A∩B) ∪(B - A∩B)
SELECT employee_id,last_name,department_name
FROM employees e LEFT JOIN departments d
ON e.`department_id` = d.`department_id`
WHERE d.`department_id` IS NULL
UNION ALL
SELECT employee_id,last_name,department_name
FROM employees e RIGHT JOIN departments d
ON e.`department_id` = d.`department_id`
WHERE e.`department_id` IS NULL;

*/


/*
#自然连接
#自然连接
#自然连接

SQL99 在 SQL92 的基础上提供了一些特殊语法,比如 NATURAL JOIN 用来表示自然连接。我们可以把
自然连接理解为 SQL92 中的等值连接。它会帮你自动查询两张连接表中 所有相同的字段 ,然后进行 等值
连接。

*/
-- 在SQL92标准中:
-- SELECT employee_id,last_name,department_name FROM employees e JOIN departments d
-- ON e.`department_id`= d.`department_id`
-- AND e.`manager_id`=d.`manager_id`;
-- 在SQL99中你可以写成:
-- SELECT employee_id,last_name,department_name FROM employees e NATURAL JOIN departments d;

/*
USING连接
USING连接
USING连接
*/
-- 当我们进行连接的时候,SQL99还支持使用USING指定数据表里的问名字段进行等值连接。但是只能配
-- 合J0IN一起使用。比如:
-- SELECT employee_id,last_name,department_name FROM employees e JOIN departments d
-- USING(department_id);

/*
和下边等值连接查询结果相同
*/
-- SELECT employee_id,last_name,department_name FROM employees e,departments d
-- WHERE e.department_id=d.department_id;
#函数
#函数
#函数

#单行函数
/*
基本函数
ABS(x)
返回x的绝对值
SIGN(X)
返回X的符号。正数返回1,负数返回-1,0返回0
PI()
返回圆周率的值
CEIL(x),CEILING(x)
返回大于或等于某个值的最小整数
FLOOR(x)
返回小于或等于某个值的最大整数
LEAST(e1,e2,e3…)
返回列表中的最小值
GREATEST(e1,e2,e3…)
返回列表中的最大值
MOD(x,y)
返回X除以Y后的余数
RAND()
返回0~1的随机值
RAND(x)
返回0~1的随机值,其中x的值用作因子值,相同的X值会产生相同的随机数
ROUND(x)
返回一个对x的值进行四舍五入后,最接近于X的整数
ROUND(x,y)
返回一个对x的值进行四舍五入后最接近X的值,并保留到小数点后面Y位
TRUNCATE(x,y)
返回数字x截断为y位小数的结果
SQRT(x)
返回x的平方根。当X的值为负数时,返回NULL
*/

-- SELECT ABS(-123),ABS(32),SIGN(-23),SIGN(43),PI(),CEIL(32.32),
-- CEILING(-43.23),FLOOR(32.32),FLOOR(-43.23),MOD(12,5) FROM DUAL;
-- SELECT RAND(),RAND(),RAND(10),RAND(10),RAND(-1),RAND(-1) FROM DUAL;
-- SELECT ROUND(12.33),ROUND(12.343,2),ROUND(12.324,-1),TRUNCATE(12.66,1),
-- TRUNCATE(12.66,-1),SQRT(9),SQRT(8),SQRT(-5) FROM DUAL;

-- SELECT TRUNCATE(ROUND(12.343,2),0) FROM DUAL;	#单行函数可以嵌套

#角度与弧度互换函数
-- RADIANS(x) 将角度转化为弧度,其中,参数x为角度值
-- DEGREES(x) 将弧度转化为角度,其中,参数x为弧度值
-- SELECT RADIANS(30),RADIANS(60),RADIANS(90),DEGREES(2*PI()),
-- DEGREES(RADIANS(90)) FROM DUAL;   #圆周长2PI

#三角函数
/*
SIN(x)
返回x的正弦值,其中,参数x为弧度值
ASIN(x)
返回x的反正弦值,即获取正弦为x的值。如果x的值不在-1到1之间,则返回NULL
COS(x)
返回x的余弦值,其中,参数x为弧度值
ACOS(x)
返回x的反余弦值,即获取余弦为x的值。如果x的值不在-1到1之间,则返回NULL
TAN(x)
返回x的正切值,其中,参数x为弧度值
ATAN(x)
返回x的反正切值,即返回正切值为x的值
ATAN2(m,n)
返回两个参数的反正切值
COT(x)
返回x的余切值,其中,X为弧度值
*/

#指数与对数
/*
POW(x,y),POWER(X,Y)
返回x的y次方
EXP(X)
返回e的X次方,其中e是一个常数,2.718281828459045
LN(X),LOG(X)
返回以e为底的X的对数,当X <= 0 时,返回的结果为NULL
LOG10(X)
返回以10为底的X的对数,当X <= 0 时,返回的结果为NULL
LOG2(X)
返回以2为底的X的对数,当X <= 0 时,返回NULL
*/

#进制间的转换
/*
BIN(x) 				返回x的二进制编码
HEX(x) 				返回x的十六进制编码
OCT(x) 				返回x的八进制编码
CONV(x,f1,f2) 返回f1进制数变成f2进制数
*/
-- SELECT BIN(10),HEX(10),OCT(10),CONV(10,2,8) FROM DUAL;

#字符串函数
#字符串函数   MySQL中,字符串的位置是从1开始的。
/*

ASCII(S)
返回字符串S中的第一个字符的ASCII码值
CHAR_LENGTH(s)
返回字符串s的字符数。作用与CHARACTER_LENGTH(s)相同
LENGTH(s)
返回字符串s的字节数,和字符集有关
CONCAT(s1,s2,....,sn)
连接s1,s2,......,sn为一个字符串
CONCAT_WS(x,s1,s2,......,sn)
同CONCAT(s1,s2,...)函数,但是每个字符串之间要加上x
INSERT(str, idx, len,replacestr)
将字符串str从第idx位置开始,len个字符长的子串替换为字符串replacestr
REPLACE(str, a, b)
用字符串b替换字符串str中所有出现的字符串a
UPPER(s) 或 UCASE(s)
将字符串s的所有字母转成大写字母
LOWER(s) 或LCASE(s)
将字符串s的所有字母转成小写字母
LEFT(str,n)
-返回字符串str最左边的n个字符
RIGHT(str,n)
-返回字符串str最右边的n个字符
LPAD(str, len, pad)
用字符串pad对str最左边进行填充,直到str的长度为len个字符
RPAD(str ,len, pad)
用字符串pad对str最右边进行填充,直到str的长度为len个字符
LTRIM(s)
-去掉字符串s左侧的空格
RTRIM(s)
-去掉字符串s右侧的空格
TRIM(s)
去掉字符串s开始与结尾的空格
TRIM(s1 FROM s)
去掉字符串s开始与结尾的s1
TRIM(LEADING s1 FROM s)
去掉字符串s开始处的s1
TRIM(TRAILING s1 FROM s)
去掉字符串s结尾处的s1
REPEAT(str, n)
返回str重复n次的结果
SPACE(n)
返回n个空格
STRCMP(s1,s2)
比较字符串s1,s2的ASCII码值的大小
SUBSTR(s,index,len)
返回从字符串s的index位置其len个字符,作用与SUBSTRING(s,n,len)、MID(s,n,len)	相同
LOCATE(substr,str)
返回字符串substr在字符串str中首次出现的位置,
作用于POSITION(substr IN str)、INSTR(str,substr)相同。未找到,返回0
ELT(m,s1,s2,…,sn)
返回指定位置的字符串,如果m=1,则返回s1,如果m=2,则返回s2,如果m=n,则返回sn
FIELD(s,s1,s2,…,sn)
返回字符串s在字符串列表中第一次出现的位置
FIND_IN_SET(s1,s2)
返回字符串s1在字符串s2中出现的位置。其中,字符串s2是一个以逗号分隔的字符串
REVERSE(s)
返回s反转后的字符串
NULLIF(value1,value2)
比较两个字符串,如果value1与value2相等,则返回NULL,否则返回value1

*/

-- SELECT INSERT('qweert',2,3,'ccccc') from DUAL;


#日期和时间函数
#日期和时间函数
#日期和时间函数


-- 获取日期、时间
/*
CURDATE() ,CURRENT_DATE()					返回当前日期,只包含年、月、日
CURTIME() , CURRENT_TIME()						返回当前时间,只包含时、分、秒

NOW() / SYSDATE() / CURRENT_TIMESTAMP() /
LOCALTIME() /LOCALTIMESTAMP()				返回当前系统日期和时间
UTC_DATE()								返回UTC(世界标准时间)日期
UTC_TIME()								返回UTC(世界标准时间)时
*/
-- SELECT CURDATE(),CURTIME(),NOW(),SYSDATE(),UTC_DATE(),
-- UTC_DATE(),UTC_TIME(),UTC_TIME() FROM DUAL;
-- SELECT CURDATE(),CURTIME(),NOW(),SYSDATE()+0,UTC_DATE(),UTC_DATE()+0,
-- UTC_TIME(),UTC_TIME()+0 FROM DUAL;  #+0  存在隐式转换

-- 2 日期与时间戳的转换
/*
UNIX_TIMESTAMP()
以UNIX时间戳的形式返回当前时间。
SELECT UNIX_TIMESTAMP() ->1634348884
UNIX_TIMESTAMP(date)
将时间date以UNIX时间戳的形式返回。
FROM_UNIXTIME(timestamp)
将UNIX时间戳的时间转换为普通格式的时间
*/
-- SELECT UNIX_TIMESTAMP(),UNIX_TIMESTAMP('2026-06-17 12:38:21'),
-- FROM_UNIXTIME(1781671101) from DUAL;

-- 获取月份、星期、星期数、天数等函数
/*
YEAR(date) / MONTH(date) / DAY(date)
返回具体的日期值
HOUR(time) / MINUTE(time) /SECOND(time)
返回具体的时间值
MONTHNAME(date)
返回月份:January,...
DAYNAME(date)
返回星期几:MONDAY,TUESDAY.....SUNDAY
WEEKDAY(date)
返回周几,注意,周1是0,周2是1,。。。周日是6
QUARTER(date)
返回日期对应的季度,范围为1~4
WEEK(date) , WEEKOFYEAR(date)
返回一年中的第几周
DAYOFYEAR(date)
返回日期是一年中的第几天
DAYOFMONTH(date)
返回日期位于所在月份的第几天
DAYOFWEEK(date)
返回周几,
注意!!!!:周日是1,周一是2,。。。周六是7

*/

-- SELECT YEAR(CURDATE()),MONTH(CURDATE()),DAY(CURDATE()),HOUR(CURTIME()),
-- MINUTE(NOW()),SECOND(SYSDATE()) FROM DUAL;#年月日时分秒
-- SELECT MONTHNAME('2021-10-26'),DAYNAME('2021-10-26'),WEEKDAY('2021-10-26'),
-- QUARTER(CURDATE()),WEEK(CURDATE()),DAYOFYEAR(NOW()),DAYOFMONTH(NOW()),DAYOFWEEK(NOW())
-- FROM DUAL;


-- 日期的操作函数
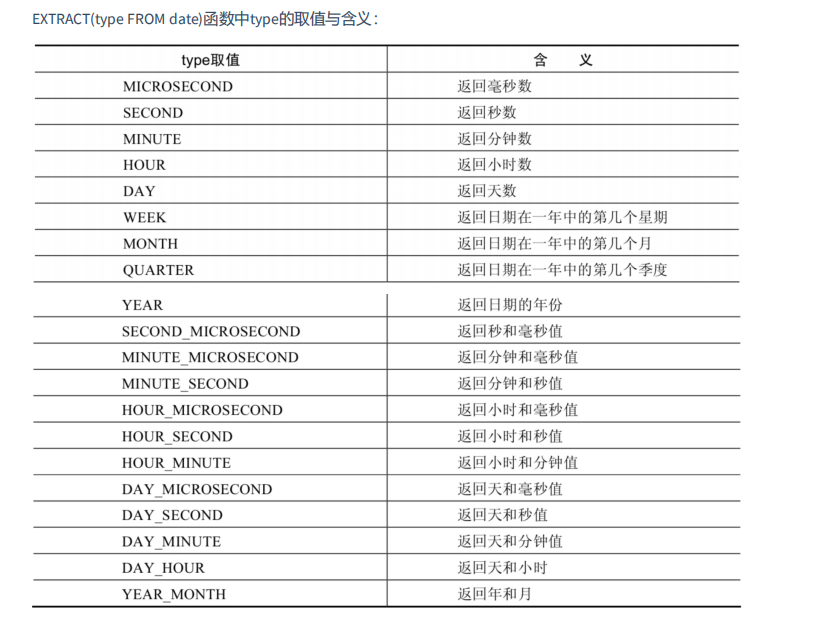
-- EXTRACT(type FROM date) 返回指定日期中特定的部分,type指定返回的值
-- SELECT EXTRACT(MINUTE FROM NOW()),EXTRACT( WEEK FROM NOW()),EXTRACT( QUARTER FROM NOW()),
-- EXTRACT( MINUTE_SECOND FROM NOW()) FROM DUAL;

-- 时间和秒钟转换的函数
-- TIME_TO_SEC(time)				将 time 转化为秒并返回结果值。
-- 转化的公式为: 小时*3600+分钟*60+秒
-- SEC_TO_TIME(seconds) 			将 seconds 描述转化为包含小时、分钟和秒的时间
-- SELECT TIME_TO_SEC(NOW());
-- SELECT SEC_TO_TIME(47484);
-- 计算日期和时间的函数
-- 计算日期和时间的函数
-- 计算日期和时间的函数

/*	函数一
DATE_ADD(datetime, INTERVAL expr type)  /    ADDDATE(date,INTERVAL expr type)
		返回与给定日期时间相差INTERVAL时间段的日期时间
DATE_SUB(date,INTERVAL expr type)	/		SUBDATE(date,INTERVAL expr type)
		返回与date相差INTERVAL时间间隔的日期
*/

-- SELECT NOW(),DATE_ADD(NOW(),INTERVAL 1 YEAR),DATE_ADD(NOW(),INTERVAL -1 YEAR) FROM DUAL;
/*
SELECT DATE_ADD(NOW(), INTERVAL 1 DAY) AS col1,DATE_ADD('2021-10-21 23:32:12',INTERVAL 1 SECOND) AS col2,
ADDDATE('2025-10-20 23:32:12',INTERVAL 1 SECOND) AS col3,
DATE_ADD('2025-10-20 23:32:12',INTERVAL '1_1' MINUTE_SECOND) AS col4,
DATE_ADD(NOW(), INTERVAL -1 YEAR) AS col5, #可以是负数
DATE_ADD(NOW(), INTERVAL '1_1' YEAR_MONTH) AS col6 #需要单引号
FROM DUAL;

SELECT DATE_SUB('2025-05-21',INTERVAL 31 DAY) AS col1,
SUBDATE('2025-06-21',INTERVAL 31 DAY) AS col2,
DATE_SUB('2025-06-21 02:01:01',INTERVAL '1 1' DAY_HOUR) AS col3
FROM DUAL;
*/


/* 函数二
ADDTIME(time1,time2)
返回time1加上time2的时间。当time2为一个数字时,代表的是秒 ,可以为负数
SUBTIME(time1,time2)
返回time1减去time2后的时间。当time2为一个数字时,代表的是 秒 ,可以为负数
DATEDIFF(date1,date2)
返回date1 - date2的日期间隔天数
TIMEDIFF(time1, time2)
返回time1 - time2的时间间隔
FROM_DAYS(N)
返回从0000年1月1日起,N天以后的日期
TO_DAYS(date)
返回日期date距离0000年1月1日的天数
LAST_DAY(date)
返回date所在月份的最后一天的日期
MAKEDATE(year,n)
针对给定年份与所在年份中的天数返回一个日期
MAKETIME(hour,minute,second)
将给定的小时、分钟和秒组合成时间并返回
PERIOD_ADD(time,n)
返回time加上n后的时间

*/

/*
SELECT
ADDTIME(NOW(),20),SUBTIME(NOW(),30),SUBTIME(NOW(),'1:1:3'),DATEDIFF(NOW(),'2021-10-01'),
TIMEDIFF(NOW(),'2021-10-25 22:10:10'),FROM_DAYS(366),TO_DAYS('0000-12-25'),
LAST_DAY(NOW()),MAKEDATE(YEAR(NOW()),12),MAKETIME(10,21,23),PERIOD_ADD(20200101010101,
10)
FROM DUAL;
*/


#日期的格式化与解析
#日期的格式化与解析
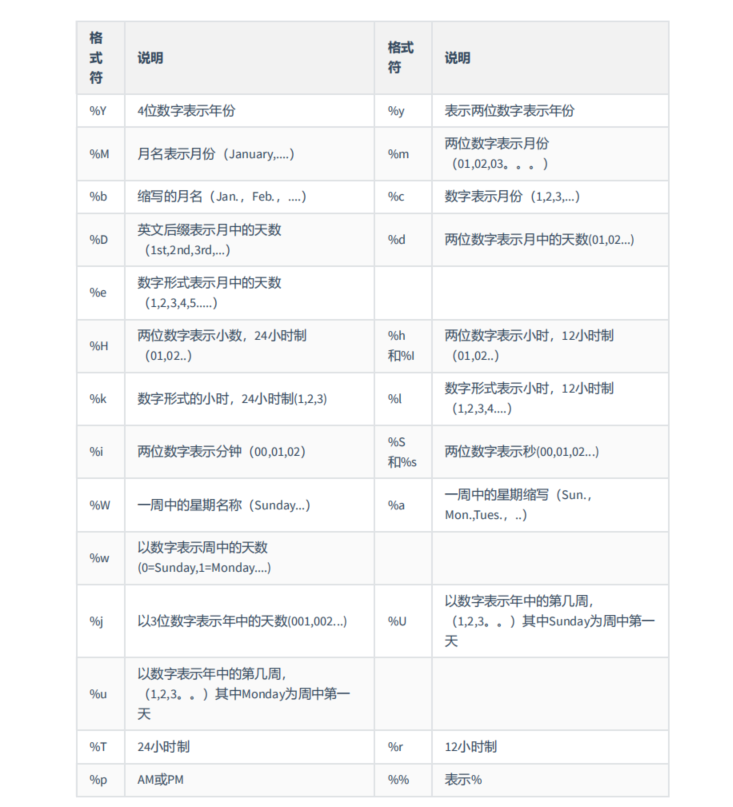
-- 格式化:日期--->字符串   解析:字符串。----> 日期

/*
DATE_FORMAT(date,fmt) 			按照字符串fmt格式化日期date值
TIME_FORMAT(time,fmt) 			按照字符串fmt格式化时间time值
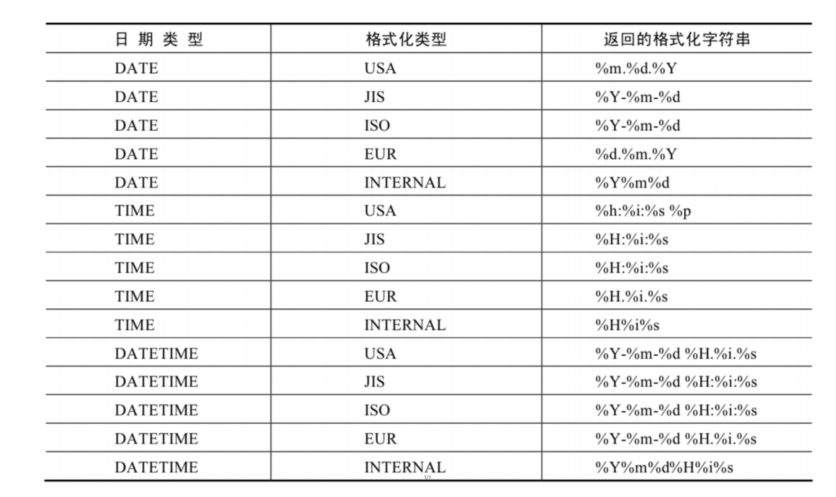
GET_FORMAT(date_type,format_type) 	返回日期字符串的显示格式
STR_TO_DATE(str, fmt) 				按照字符串fmt对str进行解析,解析为一个日期
*/

-- 上述 非GET_FORMAT 函数中fmt参数常用的格式符:
-- GET_FORMAT函数中date_type和format_type参数取值如下:
#流程控制函数
#流程控制函数
/*
流程处理函数可以根据不同的条件,执行不同的处理流程,可以在SQL语句中实现不同的条件选择。
MySQL中的流程处理函数主要包括IF()、IFNULL()和CASE()函数。
*/

-- IF(value,value1,value2)
-- 如果value的值为TRUE,返回value1,否则返回value2

-- IFNULL(value1, value2)
-- 如果value1不为NULL,返回value1,否则返回value2

-- CASE WHEN 条件1 THEN 结果1 WHEN 条件2 THEN 结果2
-- .... [ELSE resultn] END
-- 相当于编程的if...else if...else...

-- CASE expr WHEN 常量值1 THEN 值1 WHEN 常量值1 THEN
-- 值1 .... [ELSE 值n] END
-- 相当于编程的switch...case...


-- SELECT IF(1 > 0,'正确','错误');
-- SELECT IFNULL(null,'Hello Word');

-- SELECT CASE
-- 	WHEN 1 > 2
-- 	THEN '1 > 0'
-- 	WHEN 2 > 0
-- 	THEN '2 > 0'
-- 	ELSE '3 > 0'
-- 	END;

-- SELECT CASE 5 WHEN 1 THEN '1111' WHEN 2 THEN '222' ELSE '333' END;

#加密与解密函数
#加密与解密函数
#加密与解密函数

/*
PASSWORD(str)  不可逆
返回字符串str的加密版本,41位长的字符串。加密结果 不可逆 ,常用于用户的密码加密
MD5(str)  不可逆
返回字符串str的md5加密后的值,也是一种加密方式。若参数为NULL,则会返回NULL
SHA(str)   不可逆
从原明文密码str计算并返回加密后的密码字符串,当参数为NULL时,返回NULL。
SHA加密算法比MD5更加安全 。

ENCODE(value,password_seed) 返回使用password_seed作为加密密码加密value
DECODE(value,password_seed) 返回使用password_seed作为加密密码解密value

ENCODE(value,password_seed)函数与DECODE(value,password_seed)函数互为反函数
*/
-- SELECT PASSWORD('mysql'), PASSWORD(NULL);
-- SELECT md5('123');
-- SELECT SHA('Tom123');
-- SELECT ENCODE('mysql', 'mysql');
-- SELECT DECODE(ENCODE('mysql','mysql'),'mysql');

#MySQL信息函数
#MySQL信息函数
#MySQL信息函数
/*
VERSION() 返回当前MySQL的版本号
CONNECTION_ID() 返回当前MySQL服务器的连接数
DATABASE(),SCHEMA() 返回MySQL命令行当前所在的数据库
USER(),CURRENT_USER()、SYSTEM_USER()、SESSION_USER()
返回当前连接MySQL的用户名,返回结果格式为“主机名@用户名”
CHARSET(value) 返回字符串value自变量的字符集
COLLATION(value) 返回字符串value的比较规则
*/

-- SELECT DATABASE();
-- SELECT VERSION();
-- SELECT USER(), CURRENT_USER(), SYSTEM_USER(),SESSION_USER();
-- SELECT CHARSET('ABC');
-- SELECT COLLATION('ABC');

#其他函数
#其他函数
/*
FORMAT(value,n)
返回对数字value进行格式化后的结果数据。n表示 四舍五入 后保留到小数点后n位
CONV(value,from,to) 将value的值进行不同进制之间的转换
INET_ATON(ipvalue) 将以点分隔的IP地址转化为一个数字
INET_NTOA(value) 将数字形式的IP地址转化为以点分隔的IP地址
BENCHMARK(n,expr)
将表达式expr重复执行n次。用于测试MySQL处理expr表达式所耗费的时间
CONVERT(value USING char_code)
将value所使用的字符编码修改为char_code
*/

-- 如果n的值小于或者等于0,则只保留整数部分
-- SELECT FORMAT(123.123, 2), FORMAT(123.523, 0), FORMAT(123.123, -2);


#聚合函数
#聚合函数		聚合函数不能嵌套调用
#聚合函数
-- SELECT中出现的非组函数的字段必须声明在GROUP BY中
-- GROUP BY中声明的字段可以不出现在SELECT中。
-- 使用HAVING的前提是SQL中使用了GROUPBY

-- AVG()、SUM()、MAX()、MIN()、COUNT()
-- GROUP BY     HAVING
-- 都会过滤null空值


-- 下边俩只适用于数值类型的字段或变量
-- SELECT AVG(salary) from employees;
-- SELECT SUM(salary) from employees;

-- 下边俩可适用于数值类型、字符串类型、日期时间类型的字段(或变量)MAX
-- SELECT MAX(salary) from employees;
-- SELECT MIN(salary) from employees;


-- SELECT COUNT(employee_id) FROM employees;
-- SELECT COUNT(1) FROM employees;
-- count计算指定字段在查询结构中出现的个数(不包含NULL值的)
-- SELECT COUNT(commission_pct) from employees;


-- #SELECT avg(commission_pct) from employees; 不合理
-- SELECT SUM(commission_pct) / COUNT(IFNULL(commission_pct,0)) from employees; #合理

-- SELECT AVG(salary),SUM(salary),department_id from employees GROUP BY department_id;
-- SELECT AVG(salary),department_id,job_id from employees GROUP BY department_id,job_id;

#SELECT AVG(salary),department_id,job_id from employees GROUP BY department_id;
#写法错误 查询中存在的字段需要全部出现在 GROUP BY中;

-- SELECT AVG(salary),department_id from employees
-- GROUP BY department_id with ROLLUP;
-- SELECT AVG(salary) avgsal,department_id from employees
-- GROUP BY department_id ORDER BY avgsal;

-- #SELECT AVG(salary) avgsal,department_id from employees
-- GROUP BY department_id with ROLLUP ORDER BY avgsal;
-- 当使用ROLLUP时,不能同时使用ORDERBY子句进行结果排序,即ROLLUP和ORDER BY是互相排斥的


-- #select department_id,MAX(salary) FROM employees where MAX(salary)> 10000
-- GROUP BY department_id ; #错误用法
-- 如果过滤条件中使用了聚合函数,则必须使用HAVING来替换WHERE。否则报错。

-- select department_id,MAX(salary) FROM employees
-- GROUP BY department_id HAVING MAX(salary) >10000;
-- 方式1   执行效率高于方式2
-- select department_id,MAX(salary) FROM employees WHERE department_id in (20,30)
-- GROUP BY department_id HAVING MAX(salary) >10000;
-- 方式2
-- select department_id,MAX(salary) FROM employees
-- GROUP BY department_id HAVING MAX(salary) >10000 AND department_id in (20,30);

-- 当过滤条件中有聚合函数时,则此过滤条件必须声明在HAVING中。
-- 当过滤条件中没有聚合函数时,则此过滤条件声明在WHERE中或HAVING中都可以。
-- 但是,建议大家声明在WHERE

#WHERE和HAVING的对比
/*
区别1:WHERE 可以直接使用表中的字段作为筛选条件,但不能使用分组中的计算函数作为筛选条件;
HAVING 必须要与 GROUP BY 配合使用,可以把分组计算的函数和分组字段作为筛选条件。
这决定了,在需要对数据进行分组统计的时候,HAVING 可以完成 WHERE 不能完成的任务。这是因为,
在查询语法结构中,WHERE 在 GROUP BY 之前,所以无法对分组结果进行筛选。HAVING 在 GROUP BY 之
后,可以使用分组字段和分组中的计算函数,对分组的结果集进行筛选,这个功能是 WHERE 无法完成
的。另外,WHERE排除的记录不再包括在分组中。

区别2:如果需要通过连接从关联表中获取需要的数据,WHERE 是先筛选后连接,而 HAVING 是先连接
后筛选。 这一点,就决定了在关联查询中,WHERE 比 HAVING 更高效。因为 WHERE 可以先筛选,用一
个筛选后的较小数据集和关联表进行连接,这样占用的资源比较少,执行效率也比较高。HAVING 则需要
先把结果集准备好,也就是用未被筛选的数据集进行关联,然后对这个大的数据集进行筛选,这样占用
的资源就比较多,执行效率也较低。

WHERE 先筛选数据再关联,执行效率高 不能使用分组中的计算函数进行筛选
HAVING 可以使用分组中的计算函数 在最后的结果集中进行筛选,执行效率较低
*/

-- SELECT的执行过程
-- SELECT的执行过程
-- SELECT的执行过程

/*

#方式1:
SELECT ...,....,...
FROM ...,...,....
WHERE 多表的连接条件
AND 不包含组函数的过滤条件
GROUP BY ...,...
HAVING 包含组函数的过滤条件
ORDER BY ... ASC/DESC
LIMIT ...,...

#方式2:
SELECT ...,....,...
FROM ... JOIN ...
ON 多表的连接条件
JOIN ...
ON ...
WHERE 不包含组函数的过滤条件
AND/OR 不包含组函数的过滤条件
GROUP BY ...,...
HAVING 包含组函数的过滤条件
ORDER BY ... ASC/DESC
LIMIT ...,...

*/

-- SELECT 语句的执行顺序(在 MySQL 和 Oracle 中,SELECT 执行顺序基本相同)
-- FROM -- on  -- left/right join  -> WHERE -> GROUP BY -> HAVING ->
-- -> SELECT 的字段 -> DISTINCT -> ORDER BY -> LIMIT

-- 例如
/*

SELECT DISTINCT player_id, player_name, count(*) as num # 顺序 5
FROM player JOIN team ON player.team_id = team.team_id # 顺序 1
WHERE height > 1.80 # 顺序 2
GROUP BY player.team_id # 顺序 3
HAVING num > 2 # 顺序 4
ORDER BY num DESC # 顺序 6
LIMIT 2 # 顺序 7

*/


#子查询
#子查询
#子查询

-- 子查询指一个查询语句嵌套在另一个查询语句内部的查询
#方式三:子查询
-- SELECT last_name,salary FROM employees
-- WHERE salary > (SELECT salary FROM employees WHERE last_name='Abel');

-- 单行子查询  多行子查询
-- 相关子查询  不相关子查询

-- 单行比较操作符
-- > < = <>  >= =<

-- SELECT last_name from employees WHERE salary >
-- (SELECT salary from employees WHERE employee_id= 149);

-- SELECT last_name from employees WHERE job_id =
-- (SELECT job_id FROM employees where employee_id = 141)
-- AND salary >
-- (SELECT salary FROM employees WHERE employee_id = 143);

-- SELECT last_name from employees WHERE salary =
-- (SELECT MIN(salary) from employees);

-- SELECT employee_id,manager_id,department_id from employees
-- WHERE (manager_id,department_id) IN
-- (SELECT manager_id,department_id FROM employees WHERE employee_id in (141,174))
-- AND employee_id NOT IN (141,174);

-- SELECT department_id,MIN(salary) minsald from employees  WHERE
-- department_id is NOT NULL GROUP BY department_id HAVING minsald >
-- (SELECT MIN(salary) as minsal from employees WHERE department_id = 50) ;

#子查询的空值问题
-- SELECT last_name,job_id FROM employees WHERE job_id
-- = (SELECT job_id FROM employees WHERE last_name='Haas');
-- 子查询不返回任何行

-- 多行子查询
-- 多行比较操作符
-- IN		等于列表中的任意一个
-- ANY	需要和单行比较操作符一起使用,和子查询返回的某一个值比较
-- ALL		需要和单行比较操作符一起使用,和子查询返回的所有值比较
-- SOME	实际上是ANY的别名,作用相同,一般常使用ANY

-- SELECT last_name,job_id,salary from employees
-- WHERE job_id <> 'IT_PROG'
-- and salary < ANY (
-- 						SELECT salary from employees WHERE job_id = 'IT_PROG'
-- );

-- SELECT last_name,job_id,salary from employees
-- WHERE job_id <> 'IT_PROG'
-- and salary < ALL (
-- 						SELECT salary from employees WHERE job_id = 'IT_PROG'
-- );


-- 方式1
-- select department_id from employees
-- GROUP BY department_id HAVING AVG(salary)
-- <= ALL (select AVG(salary) from employees
-- WHERE department_id is NOT NULL GROUP BY department_id);
-- 方式2
-- select department_id from employees
-- GROUP BY department_id HAVING AVG(salary) =
-- (SELECT MIN(avgsal) from (select AVG(salary) avgsal from employees
-- WHERE department_id is NOT NULL GROUP BY department_id) t_sal);

#空值问题
-- 子查询 manager_id 存在 NULL 时,整条 SQL 查询结果一定为空,查不出任何数据
-- #SELECT last_name FROM employees WHERE employee_id NOT IN (SELECT manager_id FROM employees);  #空值
-- SELECT last_name FROM employees WHERE employee_id
-- NOT IN (SELECT manager_id FROM employees WHERE manager_id is NOT NULL);  #正确处理空值


-- 相关子查询
-- 相关子查询
/*
如果子查询的执行依赖于外部查询,通常情况下都是因为子查询中的表用到了外部的表,
并进行了条件关联,因此每执行一次外部查询,子查询都要重新计算一次,
这样的子查询就称之为关联子查询。相关子查询按照一行接一行的顺序执行,
主查询的每一行都执行一次子查询。
*/

-- 相关子查询
-- SELECT last_name,salary,department_id FROM employees emp
-- WHERE salary > (SELECT AVG(salary) from employees emp2
-- WHERE emp2.department_id = emp.department_id);

-- 另外方式 在from中使用子查询
-- SELECT e.last_name,e.salary,e.department_id FROM employees e,
-- (SELECT department_id,AVG(salary) avgsal from employees GROUP BY department_id) e2
-- WHERE e.department_id = e2.department_id AND e.salary > e2.avgsal;

-- SELECT employee_id,salary from employees e
-- ORDER BY (SELECT department_name FROM departments d
-- WHERE e.department_id = d.department_id);

-- 在SELECT中,除了GROUP BY 和 LIMIT之外,其他位置都可以声明子查询!
-- 在SELECT中,除了GROUP BY 和 LIMIT之外,其他位置都可以声明子查询!

-- SELECT e.employee_id,e.last_name,e.job_id from employees e
-- WHERE 2 <= (SELECT COUNT(1) FROM job_history j WHERE j.employee_id = e.employee_id);

-- EXISTS与NOT EXISTS关键字
-- EXISTS与NOT EXISTS关键字

/*

关联子查询通常也会和EXISTS操作符一起来使用,用来检查在子查询中是否存在满足条件的行。
				如果在子查询中不存在满足条件的行:		条件返回FALSE继续在子查询中查找
				如果在子查询中存在满足条件的行:			不在子查询中继续查找条件返回TRUE
NOT EXISTS关键字表示如果不存在某种条件,则返回TRUE,否则返回FALSE。

*/
-- SELECT e.employee_id,e.last_name,e.job_id from employees e
-- WHERE EXISTS (SELECT * from employees ee WHERE e.employee_id = ee.manager_id)


-- 相关更新
-- UPDATE table1 alias1 SET column=(SELECT expression
-- FROM table2 alias2 WHERE alias1.column=alias2.column);

-- 相关删除
-- DELETE FROM table1 alias1 WHERE column operator
-- (SELECT expression FROM table2 alias2 WHERE alias1.column=alias2.column);


-- 创建和管理表
-- 创建和管理表
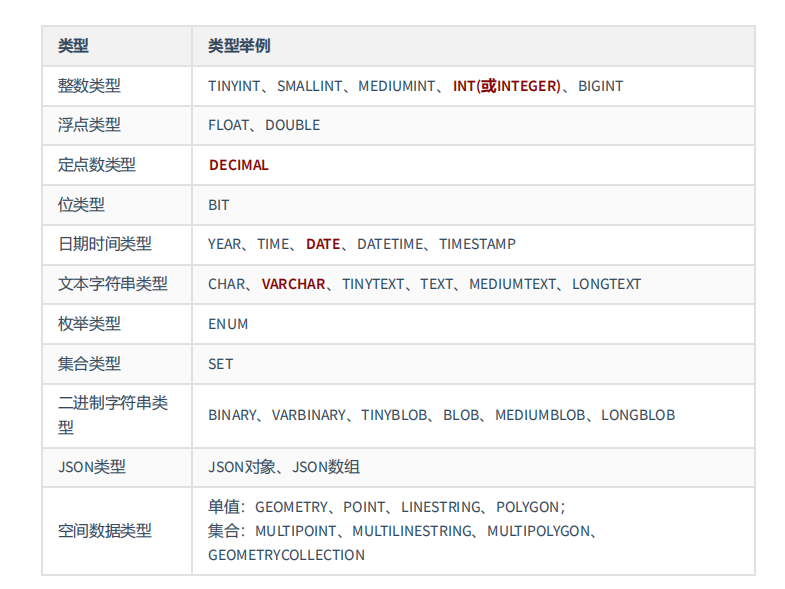
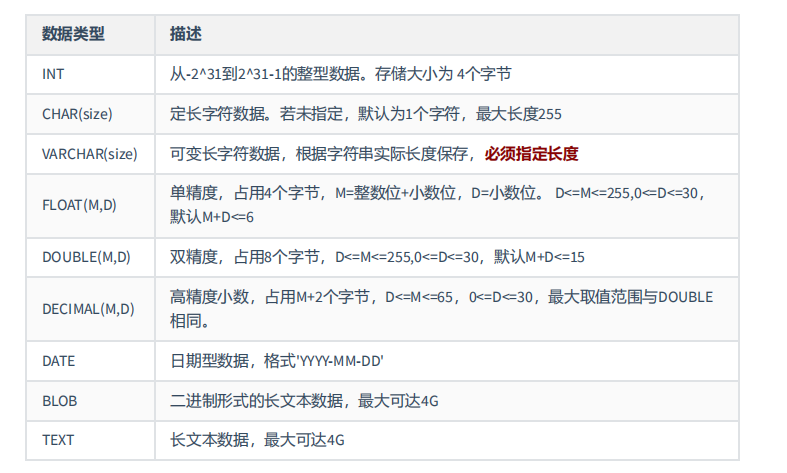
-- MySQL中的数据类型
-- 创建数据库1
-- create DATABASE mytest1;   #使用默认字符集
-- show CREATE DATABASE mytest1;
-- CREATE DATABASE mytest2 character SET 'utf8';  #指定字符集
-- CREATE DATABASE mytest3 character SET 'gbk';  #指定字符集
-- show CREATE DATABASE mytest2;
-- show CREATE DATABASE mytest3;
-- (推荐方式)
-- CREATE DATABASE IF NOT EXISTS mytest2 character SET 'utf8';

#查看数据库有哪些
-- show databases;
-- 使用数据库
-- USE mytest2;
-- 查看表
-- show tables;
-- 查看当前使用数据库
-- SELECT DATABASE() from dual;

-- 修改数据库
-- 更改字符集
-- ALTER DATABASE mytest1 character set 'gbk';
--
-- 注意:DATABASE不能改名。一些可视化工具可以改名,
-- 它是建新库,把所有表复制到新库,再删旧库完成的。

-- 删除数据库
-- DROP DATABASE mytest1;
-- (推荐方式)
-- DROP DATABASE if EXISTS mytest1;

-- 创建数据表
-- use mytest2;
-- 创建表
-- create TABLE IF NOT EXISTS myp1(
-- 	id INT,
-- 	iname VARCHAR(15),
-- 	idate DATE
-- );

-- #如果创建表没指明使用字符集则使用所在数据库的字符集
-- SHOW CREATE TABLE myp1;
-- SELECT * from myp1;
-- 基于现有的表创建表类似复制表
-- create TABLE myp2 as SELECT employee_id,last_name,salary FROM employees;
-- create TABLE myp3 as SELECT employee_id id,last_name,salary FROM employees;
-- 有别名新表列名会采用别名
-- #查看表情况
-- DESCRIBE myp2;
-- DESC myp2;
-- DESC myp3;
-- #类似复制表 但没有数据
-- create TABLE myp4 as SELECT * FROM employees WHERE 1 = 2;

-- 添加字段
-- ALTER TABLE myp4 ADD colt DOUBLE(10,2); #默认加到最后一列
-- ALTER TABLE myp4 ADD clot1 VARCHAR(20) FIRST;  #指明加到第一列
-- ALTER TABLE myp4 ADD clot2 VARCHAR(20) AFTER last_name;  #指明加到lastname 后面
-- desc myp4;

-- 修改字段
-- alter TABLE myp4 MODIFY clot2 VARCHAR(35);
-- alter TABLE myp4 MODIFY clot2 VARCHAR(35) DEFAULT 'qwer';

-- 重命名字段
-- ALTER TABLE myp4 change clot2 clotnew2 VARCHAR(25);
-- ALTER TABLE myp4 change clotnew2 clotnew3 DOUBLE(10,2);

-- 删除字段
-- ALTER TABLE myp4 DROP clotnew3;

-- 重命名表
-- 重命名表
-- rename TABLE myp4 to myp4new4; #方式一
-- alter TABLE myp4new4 RENAME to myp4; #方式二

-- 删除表
-- drop table if EXISTS myp4new4;

-- 清空表
-- TRUNCATE myp2;
-- TRUNCATE语句不能回滚,而使用 DELETE 语句删除数据,可以回滚
-- TRUNCATE TABLE 比 DELETE 速度快,且使用的系统和事务日志资源少,
-- 但 TRUNCATE 无事务且不触发 TRIGGER,不推荐开发代码使用;

/*
DCL 中 COMMIT 利 ROLLBACK
COMMIT:提交数据。一旦执行coMMIT,则数据就被永久的保存在了数据库中,意味着数据不可以回滚。
ROLLBACK:回滚数据。一旦执行ROLLBACK,则可以实现数据的回滚。回滚到最近的一次COMMIT之后。
*/
/*
DDL和DML的说明
DDL的操作一旦执行,就不可回滚。pML的操作默认情况,一旦执行,也是不可回滚的。
(DDL执行之后会执行一次commit且不受SET autocommit= FALSE 影响.)
但是,如果在执行pM之前,执行了SET autocommit= FALSE,则执行的DML操作就可以实现回滚。
*/


-- 添加数据
-- 添加数据
-- SELECT * FROM myp2;
-- #按字段顺序来
-- INSERT INTO myp2 VALUES (1,'ahha',9000,'2026-7-20');
-- 按指定字段来
-- INSERT INTO myp2(employee_id,hdate,last_name,salary)
-- VALUES(2,'2026-07-22','haha',9500);
-- 没有约束的字段不插入 会是null
-- INSERT INTO myp2(employee_id,last_name,salary) VALUES(2,'haha',9500);
-- #多行插入
-- INSERT INTO myp2(employee_id,hdate,last_name,salary)
-- VALUES(5,'2026-07-22','ww',9500),(6,'2026-07-22','rr',9500);

-- #将查询姐结果插入表中
-- 查询的字段一定要与添加到的表的字段一一对应
-- (注意字段长度范围 不能低于查询字段的长度会有风险)
-- INSERT INTO myp2(employee_id,last_name,salary,
-- hdate) SELECT * from myp222 WHERE employee_id > 3;

-- 更新数据   #	UPDATE  ... SET ... WHERE ...
-- #修改数据是可能存在不成功的情况,可能是由于约束影响造成的
-- UPDATE myp2 SET hdate = CURRENT_DATE() WHERE employee_id = 5;
-- 一次更新多个字段
-- UPDATE myp2 SET hdate = CURRENT_DATE(),salary = 10000 WHERE employee_id = 2;

-- 删除数据  delete from ... where ...
-- 如果省略 WHERE 子句,则表中的全部数据将被删除
-- 删除数据 删除数据是可能存在不成功的情况,也可能是由于约束影响造成的
-- #DELETE from myp2 WHERE employee_id = 6;

-- #小结:DML操作默认情况下,执行完以后都会自动提交数据。
-- #如果希望执行完以后不自动提交数据,则需要使用 SET auto commnit FALSE

-- MySQL8新特性:计算列
-- MySQL8新特性:计算列
/*
是某一列的值是通过别的列计算得来的。例如,a列值为1、b列值为2,c列
不需要手动插入,定义a+b的结果为c的值,那么c就是计算列,是通过别的列计算得来的
定义数据表tb1,然后定义字段id、字段a、字段b和字段c,其中字段c为计算列,用于计算a+b的
值。 首先创建测试表tb1,语句如下:
CREATE TABLE tb1(
id INT,
a INT,
b INT,
c INT GENERATED ALWAYS AS (a + b) VIRTUAL
);

INSERT INTO tb1(id,a,b) VALUES (1,100,200);
#此时会是300 修改ab值 c也会相应更改
*/

-- #创建数据库时指名字符集
-- CREATE DATABASE IF NOT EXISTS dbtest12 CHARACTER SET 'utf8';
-- SHOW CREATE DATABASE dbtest12;
-- #创建表的时候,指名表的字符集日
-- CREATE TABLE temp(id INT) CHARACTER SET 'utf8';
-- SHOW CREATE TABLE temp;
-- #创建表,指名表中的字段时,可以指定字段的字符集)
-- CREATE TABLE temp3(id INT,dname VARCHAR (15) CHARACTER SET 'GBK');
-- SHOW CREATE TABLE temp3;

-- SHOW VARIABLES LIKE 'CHARACTER%';

-- #查看约束
-- select * from information_schema.table_constraints WHERE table_name = 'employees';